[Google Trends 2026] 「単一モデル(Monolithic LLM)」の終焉と「AIソフトウェアファクトリー(AI Software Factory)」の時代:なぜエンタープライズは「複合AIシステム(Compound AI Systems)」と「GIIP」を選択するのか?
[Google Trends 2026] 「単一モデル(Monolithic LLM)」の終焉と「AIソフトウェアファクトリー(AI Software Factory)」の時代:なぜエンタープライズは「複合AIシステム(Compound AI Systems)」と「GIIP」を選択するのか?
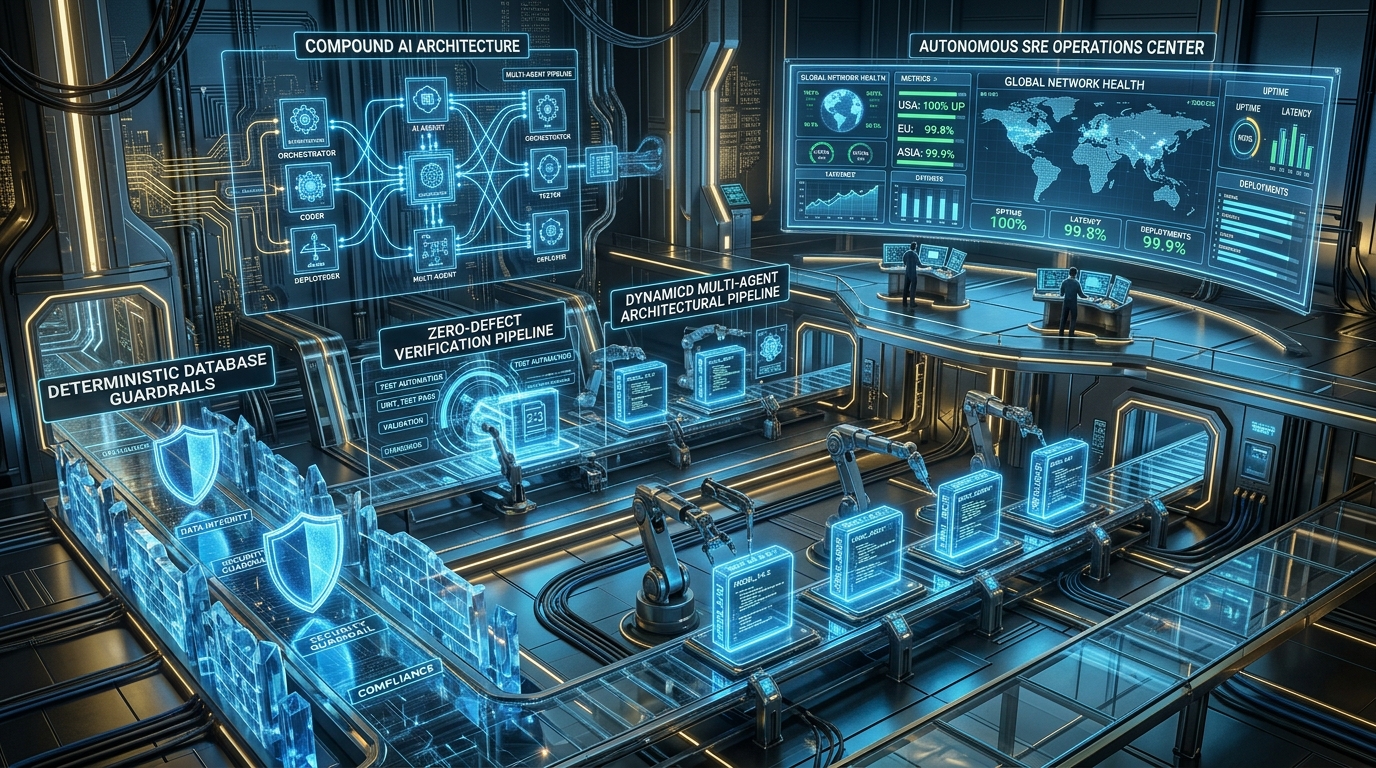
2026年のGoogleトレンド(Google Trends)およびグローバルソフトウェアエンジニアリングコミュニティにおける検索指標は、生成AIの歴史において最も重大なパラダイムシフトを鮮明に証明しています。
過去数年間、開発者コミュニティを賑わせていた**「単一巨大モデル(Monolithic LLM)」、「プロンプトの裏技」、「インラインコード自動補完(Autocomplete / Copilot)」**に関する検索ボリュームは、2024年のピークから40%以上も急落しました。エディタ上でコードを数行自動補完したり、チャットインターフェースで断片的な質疑応答を行ったりする第1世代のAIツールは、エンタープライズの本番運用(プロダクション環境)の壁に直面し、決定的な限界を露呈したためです。
対照的に、2026年のグローバルテックシーンで爆発的な急上昇を記録しているキーワードは、まったく異なるエンジニアリング領域を指し示しています。「AIソフトウェアファクトリー(AI Software Factory)」、「複合AIシステム(Compound AI Systems, CAS)」、「エージェンティックSDLC(Agentic SDLC)」、そして**「AI FDEプラットフォーム(GIIP)」に関するグローバル検索量は、前年同期比で実に520%〜630%以上も急増**しています。
スタンフォード大学、UCバークレー(BAIR)、Google Cloudの2026年最新システムリサーチレポートは、この巨大な地殻変動の本質を次のように結論付けています:
「最高水準のAIエンジニアリング成果物は、もはや『単一モデルのパラメータ規模(Monolithic Model Scale)』からは生まれない。特化型マルチエージェント、決定論的スキーマガーディアン、そしてランタイムテレメトリフィードバックループが有機的に統合された『複合AIシステム(Compound AI Systems)』によってのみ達成される。」
企業は痛感しました。いかに知能の高いフロンティアLLMであっても、単一モデルに数千行の要件定義と巨大なレガシーリポジトリを丸投げする素朴な手法は、必然的に連鎖的ハルシネーション(幻覚)、非決定論的なスキーマ破壊、そして予測不能なコスト爆発を引き起こすという現実を。
なぜ世界のトップテック企業は「単一モデル万能主義」を捨て、「AIソフトウェアファクトリー」へと舵を切っているのでしょうか? そして、シリコンバレーが注目するForward Deployed Engineer(FDE)の厳格な規律をソフトウェアプラットフォームとして完成させた**GIIP(AI FDE Platform)**は、いかにして企業の無欠陥・自律型ソフトウェア製造工場を実現しているのでしょうか?
本稿では、2026年のGoogleトレンドが示すシステム工学の構造転換を分析し、仕様駆動開発(SDD)、厳格なスキーマガーディアン(Strict Schema Guardian, No Raw SQL)、Git Worktreeによる隔離サンドボックス、Zero-Script QA、そして年間1,800億円規模の本番実績に裏打ちされた24/7 Day-2自律型SREアーキテクチャを網羅するGIIPの決定論的複合システムの優位性を徹底解剖します。
1. 2026年トレンド診断:「単一モデル」から「複合システム(Compound System)」へのパラダイムシフト
2023〜2024年のAIコーディングが「最も優れた単一のLLMを選び、プロンプトで巧みに誘導する作業」であったとすれば、2026年のエンタープライズAIは**「特化型エージェントと決定論的ツール群が連動して稼働する『ソフトウェア製造工場(Software Factory)』を設計・運用する作業」**へと進化を遂げました。
┌─────────────────────────────────────────────────────────────────────────────┐
│          📊 2026 Google Trends: ソフトウェア開発AIのパラダイムシフト         │
├─────────────────────────────────────────────────────────────────────────────┤
│  過去 (2023~2024) 単一モデル中心の時代       現在 (2026) AIソフトウェアファクトリー │
│  ─────────────────────────────────         ─────────────────────────────────│
│  • 単一巨大モデル(Monolithic LLM)万能主義    ➔ 複合AIシステム (Compound AI Systems)  │
│  • インラインコード自動補完 (Autocomplete)  ➔ 課題受付から本番デプロイまでの完全委任│
│  • 非構造化プロンプトの職人芸              ➔ 仕様駆動開発 (Spec-Driven SDLC)       │
│  • 単一セッションで全ロジック処理を試行     ➔ 役割別マルチエージェント製造ライン    │
│  • 開発者=手動でコードを叩く作業員         ➔ 開発者=工場を監督・統括する責任者    │
│  • 単純モデル検索の急落 (-40%)              ➔ AI Software Factory検索の爆増 (+620%) │
└─────────────────────────────────────────────────────────────────────────────┘
① 複合AIシステム(Compound AI Systems, CAS)とは何か?
複合AIシステムとは、単一の巨大モデルに頼り切るのではなく、複数の相互作用コンポーネント(タスク特化型の小型・大型モデル、静的コード解析ツール、決定論的スキーマ検証器、動的サンドボックス実行環境、RAGナレッジベースなど)を有機的にオーケストレーションして高度なタスクを完遂するシステムアーキテクチャです。
人間が巨大な宇宙船を建造する際、一人の天才にすべてを一任するのではなく、設計技師、溶接職人、品質検査官、安全管理官が工程を分担するように、エンタープライズソフトウェアの開発においても各工程における独立した責任と厳格な検証が不可欠です。複合AIシステムは、この工学的原則をエージェンティックAIアーキテクチャとして体現したものです。
② 「AIソフトウェアファクトリー(AI Software Factory)」の台頭
この複合AIシステムの思想をソフトウェア開発ライフサイクル(SDLC)全体に適用した完成形が、AIソフトウェアファクトリーです。
- インテイク(Intake): Jiraチケット、Slack障害通知、顧客要望仕様の自動受領。
- 仕様策定(Specification): アーキテクトエージェントがデータフロー、インターフェース型定義、検証判定基準を厳格な仕様(SPEC)として固定。
- 製造(Fabrication): 役割ごとに隔離された実装エージェント群が、ブランチごとの仮想サンドボックス上でコンポーネントとバックエンドを並行製造。
- 品質検査(Inspection): 実際の本番類似コンテナ環境で構造化JSONログとメトリクスを実測し、不具合を自動検出・再加工。
- 出荷と運用(Delivery & Ops): 無停止本番デプロイと24/7の自律自己修復(Self-Healing)。
これにより、エンジニアの役割は一行一行コードをタイピングする「作業員」から、製造パイプラインとガバナンスルールを統括し、最終承認を下す**「ソフトウェアファクトリー・スチュワード(Factory Steward)」**へと昇華しました。
2. 単一巨大モデル(Monolithic LLM)が本番運用を破綻させる4大要因
最新の数百万トークンコンテキストを誇るフロンティアLLMに、すべての仕様書とリポジトリを丸ごと流し込む素朴なアプローチを採用した企業は、ことごとく手痛い失敗に見舞われました。単一モデルへの過度な依存は、エンタープライズ環境において以下の4つの致命的な破綻(Failures)を招きます。
┌─────────────────────────────────────────────────────────────────────────────┐
│             💥 単一巨大モデル(Monolithic LLM)が引き起こす4大本番破綻         │
├─────────────────────────────────────────────────────────────────────────────┤
│  1. 単一障害点と連鎖ハルシネーション (Single Point of Failure & Cascade)     │
│     - 1つのモデルが全工程を担当し、初期の誤認が後続の全コードへ致命的に拡散  │
│  2. レイテンシと推論コストの爆発 (Latency & Inference Cost Explosion)       │
│     - 些細な修正でも数百万トークンのコンテキストを再送し、コスト・待機時間が激増│
│  3. 決定論的データ整合性の破壊 (Speculative Schema Poisoning)               │
│     - 実測メタデータなしにLLMがカラム名を推測し、危険なRaw SQLを実行してDB汚染│
│  4. 運用フィードバックの欠落と「偽りの成功」 (Fake HTTP 200 & Day-2 Blind)   │
│     - 構文上のMockテストだけを通過し、本番ランタイムでの障害を見逃す         │
└─────────────────────────────────────────────────────────────────────────────┘
① 単一障害点と連鎖的ハルシネーション
単一モデルに全工程を任せると、アーキテクチャ設計段階で犯した微細な誤謬(存在しないAPIメソッドの想定、トランザクション分離レベルの誤解など)が、実装、テスト、デプロイスクリプトへとそのままコピーされ、指数関数的に増幅します。モデル自身が自らのハルシネーションを検証するため、欠陥を自己検出することができません。
② レイテンシおよび推論コストの爆発的増大
モノレポ規模の企業システムでは、コードベースが数十万〜数百万行に達します。単一ファイルのパラメータを1つ修正するたびに巨大なコンテキスト全体をフロンティアLLMに再投入すると、1回の修正ループごとに数十秒の遅延と多額のAPIコストが消費されます。開発ループは麻痺し、月末のクラウド請求額は壊滅的な数字となります。
③ 決定論的データ整合性の破壊(Speculative Schema Poisoning)
企業システムの根幹はデータベースです。ガードレールのない単一モデルツールは、エージェントに無制限のDBアクセス権を与えてしまいます。その結果、エージェントは文脈から「それらしいカラム名」を勝手に想像してRaw SQLを発行したり、インデックスのない巨大テーブルをフルスキャンしてDBコネクションを枯渇させ、本番データを汚染します。
④ 運用フィードバックの欠落と「偽りの成功(Fake HTTP 200)」
単一モデルはエディタ画面の外の世界を知りません。過剰なモック(Mock)で取り繕ったテストをパスさせ、HTTP 200 OKが出ただけで「完了」と錯覚しますが、実際のコンテナ環境では環境変数の欠落、分散トランザクションのタイムアウトなどによる深刻なサイレント・リグレッション(Silent Regression)が発生します。
3. シリコンバレーの究極解:Forward Deployed Engineer(FDE)の工場化
この深刻な断絶を乗り越えるため、Palantir、OpenAI、DeepMindなどの先端テック企業が最重要顧客の現場に直接送り込んできたのが**Forward Deployed Engineer(FDE、前線配置エンジニア)**です。
FDEの工学的アプローチ
FDEは単なるプログラマーではありません。
- 仕様の厳格な契約化: 曖昧なビジネス要件を、機械可読で検証可能な仕様(SPEC)へと即座に落とし込みます。
- 実証第一主義(Evidence First): データベースの実際のメタデータとスキーマを実測するまで、決してクエリを推測しません。
- 製造ラインの統制: タスクを機能単位に分解し、隔離された環境で製造・相互レビュー・統合テストを徹底します。
- Day-2運用への責任: デプロイ後のレイテンシ、スロークエリ、高可用性メトリクスまで一気通貫で責任を負います。
人間FDEのスケーリング限界とプラットフォームへの昇華
しかし、卓越したFDEは世界規模でも極めて希少であり、1人あたり年間数千万円〜数億円の高額なコストがかかります。すべての企業に専任FDEチームを配置することは不可能です。
「世界最高峰のFDEが持つ仕様規律、スキーマ保護原則、マルチエージェント分業ライン、そして24/7のDay-2自律運用ノウハウを、完全なソフトウェアプラットフォームとして製品化できないか?」
この問いに対する決定論的な答えこそが、**GIIP(AI FDE Platform)**です。
4. 決定論的AIソフトウェアファクトリーを実現するGIIP(AI FDE Platform)の5大アーキテクチャ
GIIP(Global Intelligent Infrastructure Platform)は、単なるLLMのラッパーツールではありません。自律型ソフトウェア製造ラインを司るGIIP FDE Boxと、24/7で無停止本番環境を防衛するGIIP FDE Opsのデュアルコアエンジンで構築された**エンタープライズ向け複合AIシステム(Compound AI System)**です。
┌─────────────────────────────────────────────────────────────────────────────┐
│                 GIIP AI FDE Platform 複合システム構成 (Software Factory)    │
├─────────────────────────────────────────────────────────────────────────────┤
│                                                                             │
│   [企業エンジニアリングリーダー / アーキテクト]                               │
│             │                                                               │
│             ▼ (ビジネス要件・ドメイン意図の入力)                             │
│  ┌───────────────────────────────────────────────────────────────────────┐  │
│  │ 🏭 GIIP FDE Box (Autonomous Software Factory Engine)                  │  │
│  │                                                                       │  │
│  │  1. 仕様駆動開発 (Spec-Driven Development, SDD)                       │  │
│  │     - システムインターフェース、状態機械、検証合否基準を先行固定      │  │
│  │                                                                       │  │
│  │  2. 厳格なスキーマガーディアン & 動的メタデータ (No Raw SQL)          │  │
│  │     - DBメタデータ動的注入、恣意的なRaw SQL全面禁止、標準スクリプト強制│  │
│  │                                                                       │  │
│  │  3. マルチエージェント製造ライン & 隔離Git Worktree                   │  │
│  │     - Architect ➔ Backend ➔ Frontend ➔ Security 並行製造              │  │
│  │     - 隔離エフェメラル(Ephemeral)サンドボックスでコンテキスト汚染防止 │  │
│  │                                                                       │  │
│  │  4. Zero-Script QA ループ                                             │  │
│  │     - 実コンテナ実行と構造化JSONログ/テレメトリ実測                  │  │
│  │     - Fake HTTP 200を完全阻止し、セマンティックフィードバックを環流   │  │
│  └───────────────────────────────────────────────────────────────────────┘  │
│             │                                                               │
│             ▼ (事前実測検証済みの高信頼アーティファクトを出荷)               │
│  ┌───────────────────────────────────────────────────────────────────────┐  │
│  │ 🌐 マルチクラウド・エンタープライズ本番環境 (AWS / Azure / GCP)       │  │
│  │    [Next.js App Router] ──▶ [Serverless Microservices] ──▶ [Cloud DB] │  │
│  └───────────────────────────────────────────────────────────────────────┘  │
│             ▲                                                               │
│             │ (24/7リアルタイムテレメトリ環流 & 自律修復)                    │
│  ┌───────────────────────────────────────────────────────────────────────┐  │
│  │ 🛡️ GIIP FDE Ops (Autonomous Day-2 SRE Engine)                         │  │
│  │  • 年間1,800億円規模の本番運用実績に裏打ちされた無停止自律SRE         │  │
│  │  • スロークエリ実行計画(Execution Plan)自動解析 & 無停止Auto-Indexing │  │
│  │  • 障害検知時の自律ロールバック & 自己修復 (Self-Healing Loop)        │  │
│  │  • FinOpsガバナンス:LLMトークン消費量およびクラウドインフラ費用統制  │  │
│  └───────────────────────────────────────────────────────────────────────┘  │
└─────────────────────────────────────────────────────────────────────────────┘
柱1: 仕様駆動開発 (Spec-Driven Development, SDD)
GIIPソフトウェアファクトリーでは、コードを1行も書く前に、**必ず機械可読な仕様書(SPEC)と検証判定基準(Verification Criteria)**を確立します。
- 自然言語プロンプトの曖昧さを排し、入出力インターフェースの型定義、API仕様、状態遷移ルールを不変のシステム契約として確定します。
- エージェントは仕様書が定めた境界ボックス内でのみ思考・動作するため、勝手なオーバーエンジニアリングやスコープの逸脱が構造的に防止されます。
柱2: 厳格なスキーマガーディアン & 動的メタデータ注入 (No Raw SQL)
データベースの整合性は企業の生命線です。GIIPはツール実行ゲートウェイにおいて**「No Raw SQL」原則**を強制します。
- エージェントによる恣意的なRaw SQL文字列の直接発行を遮断します。
- 認証された標準スクリプト(
execSQLFile.ps1等)の経由のみを許可し、クエリ作成前にデータベースの実際のメタデータ(テーブル定義、カラム型、インデックス)を動的に注入する**実証主義(Evidence First)**を徹底します。 - これにより、存在しないカラムの参照やインデックス欠落によるDBロックを100%防止します。
柱3: マルチエージェント製造ライン & 隔離Git Worktreeサンドボックス
GIIPは単一モデルにすべてを任せるのではなく、役割ごとに厳密に分業されたデジタル製造ラインを稼働させます。
- Architect Agent: システム仕様策定とインターフェース契約の締結。
- Specialized Worker Agents: バックエンド、フロントエンドUI、データパイプラインをそれぞれ分担。
- Scoped Ephemeral Worktree: 各ワーカーにメインブランチから隔離されたGit Worktreeを動的プロビジョニングし、コマンド実行残骸やエラーログの相互汚染(Cross-Contamination)を完全に遮断。
- Reviewer & Security Agent: 仕様適合性、静的解析、セキュリティ脆弱性の検査に合格したものだけをマージ承認。
柱4: Zero-Script QA & セマンティック・ランタイム実測フィードバック
メンテナンス負荷が高く形骸化しやすい単体テストコードに依存しません。
- 実際のDockerコンテナ環境でマイクロサービスを実行し、実行時に発生する構造化JSONログとテレメトリをリアルタイムで収集・実測します。
- HTTPステータスが
200 OKであっても、レスポンスペイロード内の必須データ欠損やビジネスロジックの不整合をセマンティックレベルで自動検知し、エージェントへ即座にフィードバックします。
柱5: GIIP FDE Ops (年間1,800億円実証済みの24/7自律型SREエンジン)
ソフトウェア工場の真価は、リリース後の安定稼働(Day-2)で決まります。
- 日本のグローバルエンタープライズにおいて年間1,800億円規模の決済・物流トランザクションを無障害で防衛し続けた運用ノウハウが
GIIP FDE Opsに組み込まれています。 - スロークエリの実行計画を自動解析し、無停止で最適なインデックスを作成(Auto-Indexing)。
- 障害兆候検知時の自己修復(Self-Healing)と、LLMトークン消費量を統制するFinOpsガードレールを24時間365日提供します。
5. エンタープライズガバナンスとプラットフォーム比較分析
第1世代コーディング支援ツール、非管理型のオープンソースエージェント、そしてGIIP AI FDE Platformの比較は以下の通りです。
| 比較項目 | 第1世代ツール (Copilot, Cursor) | オープンソース・マルチエージェント | 次世代AI FDEプラットフォーム (GIIP) |
|---|---|---|---|
| システム構造 | 単一モデルによる入力補完 | 非決定論的な複数LLMループ | 決定論的複合AIシステム (Compound AI System) |
| 開発パラダイム | タイピング支援 (Typing Assistant) | 試行錯誤のプロンプト反復 | エンドツーエンドAIソフトウェアファクトリー (SDD) |
| DBガバナンス | ❌ 保護なし (人手によるレビュー) | ⚠️ 致命的リスク (推測Raw SQL実行) | ✅ Strict Schema Guardian (No Raw SQL強制) |
| 環境隔離 | ローカル作業ディレクトリ直接変更 | ホストファイルシステム汚染リスク | ✅ Git Worktreeによる隔離サンドボックス |
| 品質検証方式 | 人間の目視確認に依存 | 単純なビルド/テスト通過で終了 | ✅ Zero-Script QA & セマンティック実測環流 |
| Day-2 SRE運用 | ❌ 未対応 (DevOps手作業頼み) | ❌ 未対応 | ✅ 24/7自律型SRE (年間1,800億円実証済み) |
| 本番委任信頼度 | 15% (コードスニペット作成の域) | 25% (ハルシネーションで本番適用不可) | 99% (本番運用の完全自律委任を達成) |
定量的エンタープライズ導入成果
GIIPプラットフォームを導入したエンタープライズ組織は、圧倒的な実績を記録しています。
- 機能開発リードタイム (Time-to-Market): 要件定義から本番公開まで平均75〜80%短縮。
- 本番障害流出率 (Defect Escape Rate): スキーマガーディアンとセマンティック実測により本番重大障害ゼロ件を達成。
- 平均復旧時間 (MTTR): FDE Opsの自律診断と自己修復ループにより障害復旧時間を90%以上削減。
- 推論コスト最適化 (FinOps): 複合システムによる賢明なルーティングとスコープ隔離により、フロンティアLLMのトークン無駄遣いを68%削減。
6. 結論:2026年の技術リーダーへ — 「より大きなモデルを探すのではなく、より完全な工場を築け」
2026年のGoogleトレンドが世界のテックリーダーに突きつけているメッセージは明白です。
ベンチマークスコアが数点高いだけの新しい巨大モデルが登場しても、企業のレガシーシステムの複雑性とデータガバナンスの壁が自然に消滅することはありません。「単一巨大モデル万能主義」の時代は完全に終わりました。
真のエンジニアリング競争力の差は、**「いかに洗練された複合AIシステム(Compound AI System)としてソフトウェアファクトリーを構築し、決定論的な安全網の中でエージェントに自律的実行権を委任できるか」**によって決定づけられます。
仕様駆動開発(SDD)の厳格な規律、Strict Schema Guardianの鉄壁の防護、エフェメラルサンドボックスの清浄な製造環境、そして1,800億円の本番運用を守り抜いた24/7自律SREエンジンを統合した**GIIP(AI FDE Platform)**こそが、エンタープライズが次世代のソフトウェア開発競争を制するための決定的な選択肢です。
💡 エグゼクティブサマリー (Executive Summary)
- Google Trends 2026の構造変化: 単一モデルや単純コード補完の検索が40%下落する一方、「AI Software Factory」「Compound AI Systems(複合AIシステム)」の検索は520〜630%急増しています。
- 単一モデルの限界と複合システムの必然性: 単一LLMへの依存は連鎖ハルシネーション、コスト爆発、スキーマ汚染を招きます。システムの知能は、特化型コンポーネントを有機的に連動させる複合システムから生まれます。
- GIIP AI FDE Platformの圧倒的価値: FDEの規律を体系化したGIIPは、自律製造ライン(GIIP FDE Box)と24/7自律運用(GIIP FDE Ops, 1,800億円実証)により、エンタープライズに99%の本番運用信頼性を提供します。
コメント
コメントを投稿